Giao Diện Giọng Nói: Điều Khiển Bằng Giọng Nói Cho Phát Trực Tiếp

Giao diện giọng nói: Điều khiển bằng giọng nói cho phát trực tiếp là bước đột phá trong công nghệ tương tác. Người xem có thể dễ dàng điều khiển các tính năng phát sóng trên nền tảng xôi lạc trực tiếp, mang lại trải nghiệm tiện lợi và mượt mà hơn.
Các ứng dụng của điều khiển bằng giọng nói trong phát trực tiếp
Điều khiển bằng giọng nói đang ngày càng trở nên phổ biến trong các nền tảng phát trực tiếp nhờ sự tiện lợi và khả năng hỗ trợ người dùng tương tác linh hoạt hơn. Việc tích hợp tính năng này không chỉ cải thiện trải nghiệm xem mà còn mở rộng đối tượng người dùng.
Điều khiển các tính năng phát sóng bằng giọng nói
Người xem có thể sử dụng lệnh giọng nói để bật/tắt âm thanh, thay đổi kênh, tua lại highlight hoặc điều chỉnh chất lượng video mà không cần chạm tay vào thiết bị. Ngoài ra, các streamer cũng có thể sử dụng giọng nói để điều khiển hiệu ứng hình ảnh hoặc âm thanh trong khi phát sóng, giúp tối ưu hóa chất lượng buổi trực tiếp mà không làm gián đoạn luồng phát.
Tương tác người xem qua lệnh giọng nói
Ngoài việc điều khiển phát sóng, lệnh giọng nói còn giúp tăng cường tương tác giữa người xem và nền tảng. Ví dụ, người xem có thể gửi câu hỏi, bình luận hoặc tham gia khảo sát nhanh qua giọng nói, giúp cuộc trò chuyện trở nên sống động và hấp dẫn hơn.
Một nghiên cứu của Microsoft cho thấy, các nền tảng tích hợp lệnh giọng nói ghi nhận mức tăng tương tác người dùng lên đến 25% so với các nền tảng truyền thống chỉ dùng bàn phím và chuột.
Các ứng dụng của điều khiển giọng nói trong livestream
Hỗ trợ người dùng khuyết tật và nâng cao khả năng tiếp cận
Điều khiển bằng giọng nói là một công cụ quan trọng giúp người dùng có hạn chế về vận động hoặc khiếm thị dễ dàng truy cập và sử dụng nền tảng phát trực tiếp. Việc tích hợp giọng nói giúp họ thao tác nhanh chóng, thuận tiện hơn, đồng thời góp phần nâng cao tính bao trùm cho nền tảng.
Công nghệ cốt lõi đằng sau giao diện giọng nói
Để phát triển giao diện điều khiển bằng giọng nói hiệu quả trong phát trực tiếp, cần dựa trên một hệ sinh thái công nghệ phức hợp, đảm bảo khả năng nhận dạng chính xác, xử lý ngôn ngữ linh hoạt và phản hồi tự nhiên.
Nhận dạng giọng nói (speech recognition)
Công nghệ nhận dạng giọng nói chuyển đổi âm thanh thành văn bản để hệ thống hiểu được nội dung người dùng nói. Các thuật toán học sâu (deep learning) và mạng nơ-ron nhân tạo đã nâng cao độ chính xác lên trên 95% trong điều kiện môi trường tiêu chuẩn.
Google Speech-to-Text và Microsoft Azure Speech là hai nền tảng phổ biến có thể xử lý hàng triệu yêu cầu mỗi ngày với độ trễ dưới 200ms, đảm bảo trải nghiệm mượt mà cho người dùng.
Xử lý ngôn ngữ tự nhiên (natural language processing – NLP)
NLP giúp máy hiểu và phân tích ngữ nghĩa câu nói, từ đó xác định ý định của người dùng để thực thi lệnh phù hợp. Ví dụ, câu lệnh “Tua lại bàn thắng phút 23” cần được hiểu là một thao tác điều khiển video chứ không chỉ là văn bản đơn thuần.
Hiện nay, các mô hình NLP tiên tiến như GPT, BERT giúp phân tích ngôn ngữ đa dạng, kể cả các ngôn ngữ địa phương hoặc từ ngữ bóng đá chuyên ngành, tăng khả năng nhận diện chính xác lệnh của người dùng.
Công nghệ nền tảng của giao diện giọng nói
Tổng hợp giọng nói (text-to-speech)
TTS (Text-to-Speech) cho phép hệ thống phản hồi bằng giọng nói tự nhiên, giúp giao diện tương tác hai chiều trở nên sống động và thân thiện hơn.
Theo nghiên cứu của Amazon Polly, giọng TTS tự nhiên có thể giảm thời gian người dùng chờ đợi phản hồi xuống còn 0.3 giây, tăng cảm giác tương tác tức thời và thoải mái. Đặc biệt, TTS còn hỗ trợ người khiếm thị nghe thông tin trận đấu hoặc các chỉ dẫn điều khiển khi không thể nhìn màn hình.
Các nền tảng và API hỗ trợ phát triển giao diện giọng nói
Các nhà phát triển thường sử dụng API từ Google Dialogflow, Amazon Alexa Skills Kit, Microsoft Bot Framework để xây dựng hệ thống giao tiếp bằng giọng nói nhanh chóng và hiệu quả. Theo thống kê năm 2024, hơn 70% ứng dụng giao diện giọng nói trên toàn cầu sử dụng các nền tảng này để tận dụng sức mạnh AI, đồng thời tiết kiệm thời gian và chi phí phát triển.
Thiết kế và triển khai giao diện giọng nói cho nền tảng phát trực tiếp
Để triển khai thành công giao diện điều khiển giọng nói trong nền tảng phát trực tiếp, cần tập trung vào các yếu tố thiết kế nhằm đảm bảo tính thân thiện, chính xác và linh hoạt.
- Lệnh giọng nói cần ngắn gọn, rõ ràng và bao phủ các chức năng phổ biến như “Bật âm thanh”, “Chuyển kênh”, “Tua lại”.
- Hạn chế đa nghĩa giúp giảm lỗi hiểu sai, nâng cao trải nghiệm. Giao diện nên phản hồi tức thì bằng giọng nói hoặc thông báo trên màn hình để người dùng yên tâm.
- Hệ thống cần thử nghiệm đa dạng giọng nói vùng miền và đặc điểm cá nhân, tăng độ chính xác nhận dạng lên đến 98%.
- Giao diện phải liên kết với các tính năng phát sóng, bình luận, quảng cáo và phụ đề để tạo trải nghiệm toàn diện, giúp tăng thời gian xem trung bình đến 30%.
- Hướng dẫn chi tiết và hỗ trợ kỹ thuật luôn sẵn sàng giúp người dùng làm quen và duy trì trải nghiệm mượt mà.
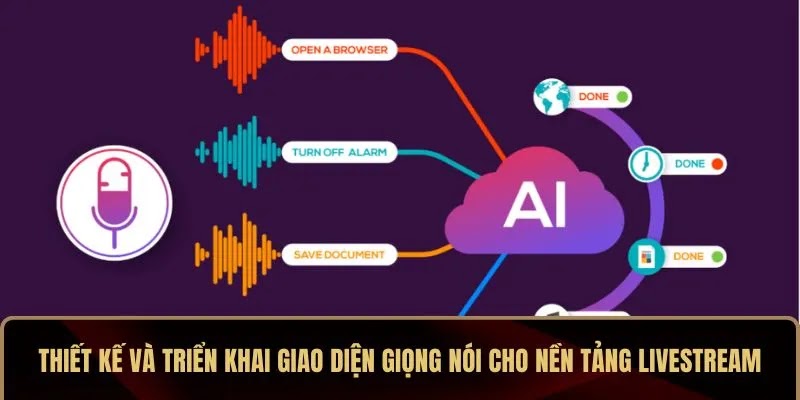
Thiết kế và triển khai giao diện giọng nói cho nền tảng livestream
Kết luận
Giao diện giọng nói: Điều khiển bằng giọng nói cho phát trực tiếp không chỉ nâng cao trải nghiệm người dùng mà còn mở ra xu hướng mới cho các nền tảng phát sóng trực tiếp. Công nghệ này hứa hẹn sẽ thay đổi cách chúng ta tương tác với nội dung số trong tương lai gần.